Eine Woche seit dem letzten Eintrag, und zum ersten Mal schliesst sich der Kreis: Die App erkennt nicht mehr nur, welche Teile im Haufen liegen, sondern zeigt auch, was daraus gebaut werden kann.
Modellvorschläge mit Bauanleitung
Ich entwerfe eigene kleine Modelle am Computer, im freien LDraw-Format, mit dem Konstruktionsprogramm LeoCAD. Ein Skript macht daraus ein Paket für die App: Teileliste, Bilder jedes Bauschritts und Miniaturen jedes Teils. Die Bilder rendert LeoCAD mit der offiziellen Teilebibliothek von LDraw.org. Baugruppen, die in einem Modell mehrfach vorkommen, erscheinen in der Anleitung als eigener Abschnitt mit dem Hinweis "2× bauen".
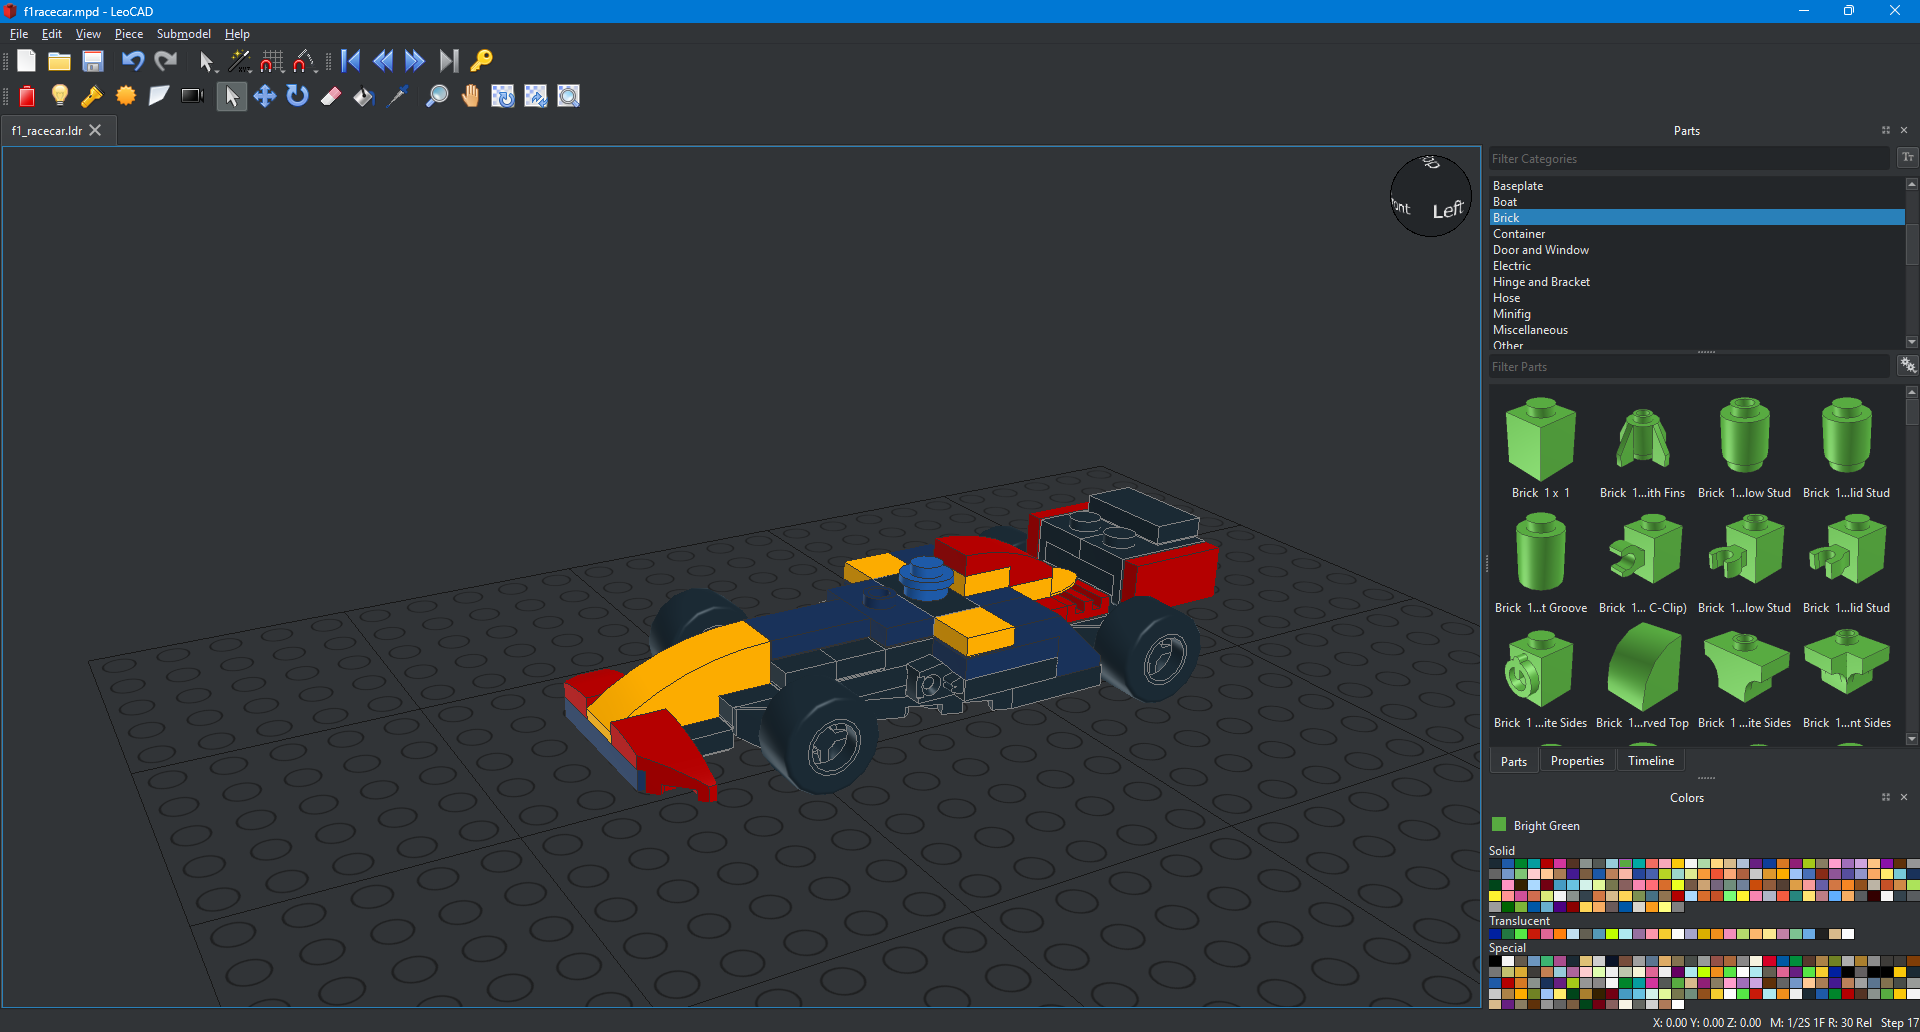
Nach einem Scan vergleicht die App die erkannten Teile mit den Teilelisten und sortiert die Modelle: zuerst die vollständig baubaren, dann nach dem Anteil vorhandener Teile. Die Teileliste zeigt, was fehlt. Die Farbe lasse ich beim Abgleich bewusst weg: Sie ist die unsicherste Stufe der Erkennung, und die meisten Modelle lassen sich auch in anderen Farben bauen.
Im Moment sind es sechs Entwürfe, darunter ein kleines Flugzeug, zwei Rennwagen und mehrere Raumschiffe. Einige ihrer Teile kennt die Erkennung noch nicht. Sie sind in der Teileliste markiert, und mit jedem neuen Modell wächst die Liste der Teile, die als Nächstes in den Katalog sollen.
Seit heute gibt es in der App Schaltflächen zur Umschaltung zwischen Aufnahme und Anleitung. So kann also mitten in einer Aufnahme kurz in die Anleitung wechseln und zurück, ohne dass etwas verloren geht. Neue Modelle sollen ohne neue App-Version aufs Handy kommen. Z.B. als ZIP-Datei, die in die App importiert wird.
Gleiche Teile sauber auseinanderhalten
Die App fotografiert jeden Haufen aus drei Blickwinkeln und ordnet zu, welche Ausschnitte zum selben physischen Teil gehören. Bei mehreren gleichen Exemplaren ging das schief: Die Zuordnung orientierte sich an den ähnlichsten Ausschnitten, und bei identischen Teilen ist "am ähnlichsten" Zufall. In drei Testszenen wurden dadurch Exemplare wild vermischt.
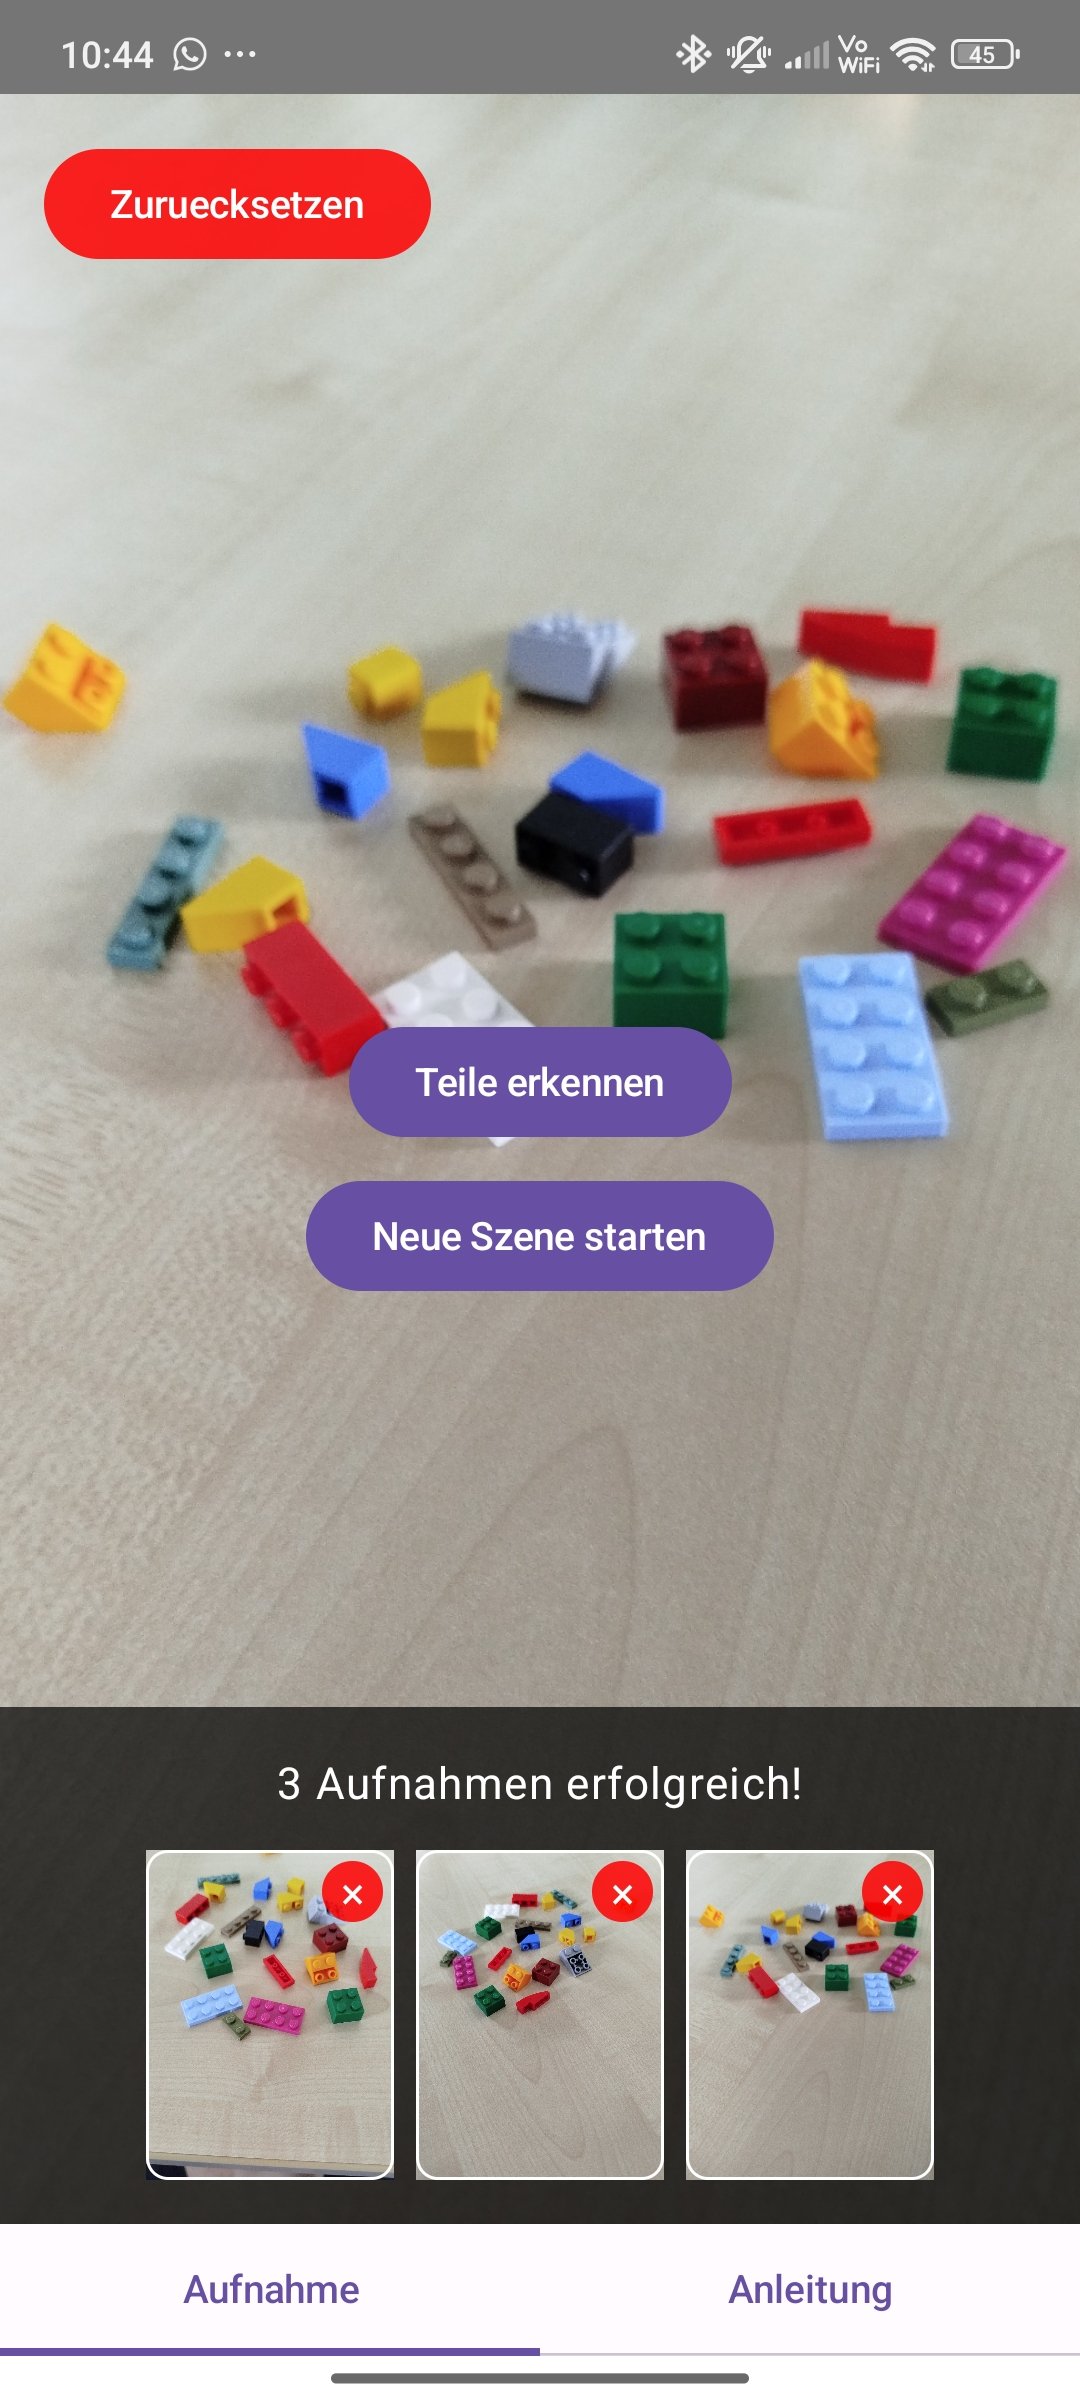
Jetzt berücksichtigt sie mehrere Kandidaten pro Ausschnitt und lässt nur plausible Abbildungen zwischen den Ansichten zu. In den drei Problemszenen stimmt die Zuordnung jetzt genau. Über alle 21 geprüften Szenen stieg die Trefferquote der Zuordnung von 92 auf 98 %, keine Szene wurde schlechter.
Eine zweite Stolperfalle waren unterschiedliche Hintergründe (z.B. Tischfarbe). Bei schwarzem Hintergrund schwankt die gemessene Farbe desselben Teils von Ansicht zu Ansicht deutlich stärker, und eine zu strenge Farbgrenze trennte zusammengehörende Ansichten. In drei dichten Szenen mit je 30 Teilen fand die App 35 bis 38 Objekte. Mit gelockerter Grenze sind es 31 bis 32.
Echte Fotos aus Danzig
Für das Erkennungsmodell nutze ich einen frei verfügbaren Datensatz mit Teilefotos. Er enthält über 28 000 Fotos zu 123 Teilen aus meinem Katalog. Mit 6 000 davon im Training stieg die Erkennung auf dem schwarzen Tisch von 52 auf 83 % der Ansichten. Auf den übrigen Testszenen änderte sich wenig, dort war die Erkennung schon gut.
Wichtiger ist der Effekt bei neuen Teilen. Kennt die App ein Teil nur aus Renderings, erkannte sie in einem Versuch 8 von 24 Objekten, mit 60 echten Fotos pro Teil im Katalog 14 von 24. Der Katalog füllt deshalb jetzt jedes Teil mit solchen Fotos auf. Ein neu hinzugefügtes Teil profitiert also schon, bevor ich es selbst fotografiert habe.
Das Nachtrainieren läuft inzwischen per Knopfdruck in meinem Prüfwerkzeug am PC. Ein neues Modell wird nur übernommen, wenn es auf sieben zurückgehaltenen Testszenen mit 126 Objekten mindestens so gut abschneidet wie das bisherige. Der erste Lauf scheiterte prompt daran, obwohl die Trainingsmetrik besser aussah.
Kleinere App, kürzere Wartezeit
Die App war zu gross und zu hungrig. Mit einem Release-Build nur für heutige 64-Bit-Handys und Modellen in kompakterem Zahlenformat (INT8) schrumpfte die Installationsdatei von 525 auf 213 MB. Der Arbeitsspeicher nach dem Start sank von etwa 850 auf 334 MB, das Ziel unter 400 MB ist damit erreicht. Die Modelle werden jetzt direkt aus der Installationsdatei gelesen statt zuerst in den Speicher kopiert.
Bei der Rechenzeit gab es heute zwei Erkenntnisse:
- Das Testhandy hat vier schnelle und vier sparsame Prozessorkerne. Die Erkennung rechnete mit sechs Threads und teilte jeden Rechenschritt gleichmässig auf. Landete ein Teil der Arbeit auf einem sparsamen Kern, warteten alle anderen darauf. Dasselbe Foto brauchte so mal 17, mal 37 Sekunden. Mit genau vier Threads sind es gleichmässig 13 Sekunden.
- Jedes Foto wird jetzt gleich nach der Aufnahme im Hintergrund ausgewertet. Das erste läuft also schon, während die zweite und dritte Ansicht fotografiert wird.
Zusammen mit einem Bildschirm, der während der Auswertung nicht mehr ausgeht (und dabei die App bremste), sank die Wartezeit nach dem Tippen auf "Teile erkennen" von 72 bis 86 auf 48 Sekunden.
Als Nächstes
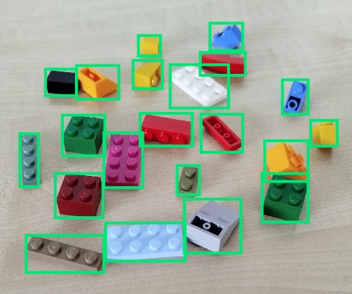
48 Sekunden sind immer noch weit weg von meinem Ziel. Den grössten Teil frisst die Segmentierung mit 13 Sekunden pro Foto. Das Modell vollständig in INT8 umzurechnen, hatte ich schon versucht - das war auf dem PC zehnmal langsamer. Bleiben kleinere Eingabebilder oder ein schlankeres Modell, beides muss ich gegen die Erkennungsqualität abwägen. Daneben kommen die Teile der neuen Modelle in den Katalog.